1. 로지스틱 회귀분석
1) 개념
- 종속변수가 범주형인 경우에 적용할 수 있는 회귀분석 모형
- 종속변수가 특정 범주에 속할 확률을 0에서 1사이의 값으로 예측하고, 가능성이 더 높은 범주로 분류하는 지도학습 알고리즘
2) 원리
- 선형회귀와 달리 y = b0+b1x1+u 등으로 나타낼 수 없음
- 따라서 로지스틱 회귀분석에서는 범주형 변수 Y의 기댓값 E(Y) = P(Y=1)가 -무한대에서 +무한대 사이의 값을 가질 수 있도록 로짓 변환을 실시함
- 로짓변환이란 E(Y)를 log P(Y=1) / 1 - P(Y=1)로 만드는 함수적 변환
a. 오즈
- Y=1인 경우가 성공일 때, 오즈는 p/1-p 즉, 성공확률 / 실패확률
- 오즈는 0에서 무한대 사이의 값을 가짐
b. 로그 오즈
- 오즈에 로그 함수를 적용시킨 것으로 -무한대에서 +무한대 사이의 값을 가짐 (log p/1-p)
- 로짓 변환을 통해 계산되는 로지스틱 회귀식은 B0 + B1x1 +,,, 등으로 표현 가능
- 여기서 Bk는 Xk가 한 단위 증가할 때 Y=1에 대한 오즈가 exp(Bk)배 만큼 증가 or 감소함을 의미함
c. 시그모이드 함수

- 로지스틱 회귀 분석을 통해 알고싶은 것은 로그 오즈 값이 아닌 종속변수 값이 성공인지 실패인지 분류하기 위한 성공확률
- 따라서 확률 P값을 추정할 수 있도록 회귀식을 P에 대해 정리한 것이 바로 시그모이드 함수
- 이때 성고아확률과 실패확률이 0.5로 같아지는 경우가 가장 불순도가 높은(불확실성이 높은) 상태
d. 로지스틱 회귀모형 해석하기
- X가 성별 (남=1 여=0)
- Y가 구매 여부 (구매=1 미구매=0)일 경우
| log p/1-p = a+ bx --------> p = 1 / 1+exp[-(a+bx)] (시그모이드 함수) |
- 여기서 b >0이면 남성의 구매확률에 대한 구매의 오즈가 여성에 비해 exp(b)배 만큼 높다는 것을 의미
- 회귀계수가 매우 작게 추정될 경우, 독립변수와 관계 없이 상수인 확률 0.5를 가지는 구조 (불확실성)
3) 임계값
- 로지스틱 회귀분석 결과로 나오는 분류 확률이 특정 수준보다 큰지 혹은 작은지를 기준으로 해당 데이터가 어떤 클래스에 속할지 분류할 수 있으며 이때 기준이 되는 값을 임계값이라고 함
- 일반적으로 0.5로 설정되며, 성공확률이 0.5보다 크면 성공, 0.5보다 작으면 실패로 분류
- 필요에 따라 임의로 임계값을 변경 가능 (암 진단의 경우 임계값을 낮춤, 일명 안전빵)
2. 의사결정 나무
1) 개념
- 분류함수를 의사결정 규칙으로 이뤄진 나무 모양으로 그리는 방법
2) 분석 과정
a. 성장 단계
- 각 마디에서 적절한 최적의 분리규칙을 찾아서 나무를 성장시키는 과정으로, 적절한 정지규칙을 만족하면 중단됨
- 정지 규칙은 더 이상 분리가 일어나지 않고, 현재의 마디가 끝마디가 되도록 하는 규칙 (깊이/끝 마디 개수를 지정)
- 정지 규칙이 일어나는 조건은 뎁스가 최대이거나, 마지막 가지 끝에 남은 개수가 일정 개수 이하이거나, 유의성 임계치 미달
- 분리 기준은 이산/연속형 목표변수에 따라 나뉨
● 이산형 목표변수
- 분류나무: 목표변수가 이산형인 경우, 상위 노드에서 가지 분할을 할 때 분류변수와 분류 기준값의 선택 방법으로 카이제곱 통계량의 p값, 지니 지수, 엔트로피 지수가 사용됨
● 연속형 목표변수
- 회귀나무: 목표변수가 연속형인 경우, 분류 변수와 분류 기준값의 선택 방법으로 F-통계량 값, 분산의 감소량 등이 사용됨
b 가지치기 단계
- 오차를 크게할 위험이 높거나 부적절한 추론 규칙을 가지고 있는 가지 등을 제거하는 단계
- 나무의 크기를 모형의 복잡도로 볼 수 있음
- 일반적으로 마디에 속하는 자료가 일정 수 이하일 때 분할을 정지하고 비용-복잡도 가지치기를 이용
c. 타당성 평가 단계
- 이익도표, 위험도표, 시험용 데이터를 이용해 의사결정나무를 평가
d. 해석 및 예측 단계
- 구축된 나무모형을 해석하고 예측 모형을 설정한 후 예측에 적용
3) 알고리즘
a. CART (Classification And Regression Tree)
- 가장 많이 활용되는 알고리즘으로 불순도의 측도로 출력 변수가 범주형일 경우 지니지수를 이용, 연속형인 경우 분산을 이용한 이진 분리를 사용
- 목표 변수를 가장 잘 분리하는 변수와 그 분리시점을 찾는 척도 중 하나가 '다양성'
- 노드의 다양성을 가장 많이 줄이는 설명변수를 선택, 분리기준은 다음 값을 가장 크게 하는 곳을 선택
- 즉, 분리 전 다양성을 크게 하는 곳을 분리 기준으로 정함
b. C4.5와 C5.0
- CART는 이진분리를 하지만 C4.5는 각 마디에서 다지분리가 가능
- 범주형에서는 범주의 수만큼 분리가 일어남
- 멀리 떨어져있는 데이터에 대해서는 언급하지 않고 가지치기를 함 (소수의 데이터를 설명하기 위해 분기를 만들지 않음)
c. CHAID (Chi-squared Automatic Interaction Detection)
- 가장 오래된 알고리즘이고, SPSS나 SAS 패키지에서 가장 보편적으로 사용
- 카이제곱 또는 F 검정을 이용해 다지분리를 수행
- CART와 다른 점은 데이터를 과적합하기 전에 나무 형성을 멈춤
4) 장단점
a. 장점
- 구조가 단순하여 직관적 이해 및 해석 용이
- 유용한 입력 변수 파악
- 선형성, 정규성, 등분산성 등 통계적 가정이 불필요
- 계산 비용이 낮음
- 수치형, 범주형 모두 사용 가능
b. 단점
- 경계선 부근의 자료값에 대해서는 오차가 큼
- 로지스틱 회귀처럼 각 예측변수의 효과를 파악하기 어려움
- 새로운 자료에 대한 예측이 불안정
3. 서포트 벡터 머신 (SVM)
- 패턴인식, 자료 분석 등을 위한 지도학습 머신러닝 모델로 회귀나 분류에 사용
- 새로운 데이터가 어떤 범주에 속할 것인지를 판단하는 비확률적 이진 선형 분류 모델을 생성
- 기존 분류기는 오류율 최소화를 특징으로 한다면 SVM은 마진 최대화로, 일반화 능력의 극대화를 추구
- 지도학습
1) 원리
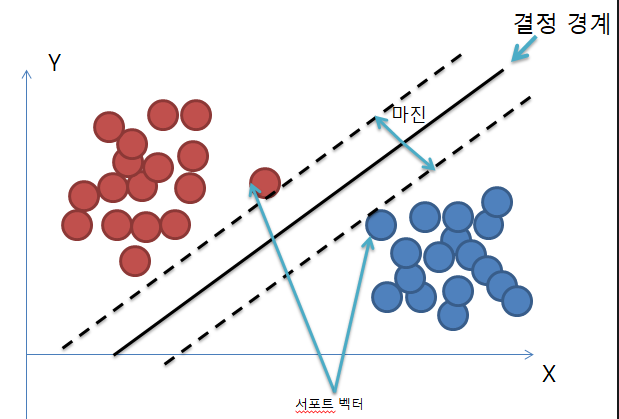
- SVM 분류 모델은 데이터가 표현된 공간에서 분류를 위한 경계를 정의
- 분류되지 않은 새로운 값이 입력되면 경계의 어느 쪽에 속하는지를 확인하여 분류 과제를 수행
- 위 그림에서 빨간 원과 파란 원을 구분하는 경계선은 아주 많이 생성될 수 있음 수많은 경계선 중 SVM은 두 집단에 속한 데이터들 사이에서 갖아 큰 폭을 가진 경계를 찾음
- 해당 경계면과 같이 데이터의 각 그룹을 구분하는 분류자를 '결정 초평면'이라고 함
- 초평면에 가장 가까이에 붙어있는 최전방 데이터들이 결정 경계를 지지(support)하기 때문에 이 점들을 서포트 벡터라고 함
- 서포트 벡터와 초평면 사이의 수직거리가 바로 마진
- SVM은 이와 같이 고차원 혹은 무한 차원의 공간에서 마진을 최대화하는 초평면을 찾아 분류와 회귀를 수행
2) 적절한 마진의 선택
- 자신의 클래스가 아닌 다른 클래스 쪽에 가깝게 위치한 데이터(이상치)가 존재할 경우, 약간의 오류를 허용하기 위한 파라미터 cost(C)를 활용
- C는 데이터가 다른 클래스에 놓이는 것을 허용할 정도를 결정
- C값을 작게 설정하면 이상치가 존재할 가능성을 많이 허용하여 더욱 일반적인 경계면을 찾고, C값을 크게설정하면 이상치의 존재 가능성을 작게 허용하여 더욱 세심한 분류 경계면을 찾음
a. 소프트 마진
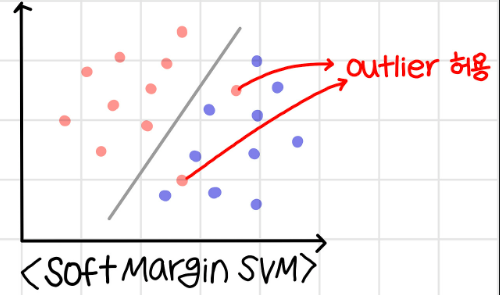
- C값을 작게 설정하여 이상치를 어느 정도 허용함
- 하지만 C값을 지나치게 작게 설정하면 과소적합의 문제가 발생할 수 있음
b. 하드 마진
- C값을 크게 설정하여 이상치의 존재를 허용하지 않는 까다로운 모델
- 매우 좁은 마진을 갖게 됨
- 과적합 문제 발생 가능
3) 커널
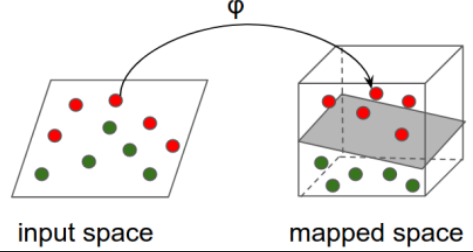
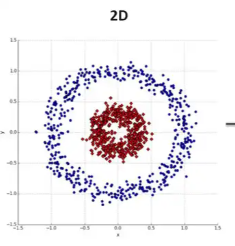
- SVM 모형은 선형 분류 뿐만 아니라 비선형 분류에도 사용됨
- 비선형 데이터의 분류 문제는 입력자료를 다차원 공간으로 매핑하여 해결할 수 있으며 이 과정에서 커널 함수를 이용해 계산량을 줄이는 기법인 커널 트릭이 사용됨
- 좌측 공간처럼 데이터가 분포되어 있을 땐 선형의 분류로 원들을 분류할 수 없음 하지만, 3차원 공간에 매핑할 시 데이터 분류가 가능
- 이후 3차원 공간에서 분류된 데이터를 다시 2차원 공간으로 매핑해 보면 결정 경계가 둥그런 비선형의 형태를 띰
4) 장단점
| 장점 | 단점 |
| - 분류와 예측에 모두 사용 가능 - 신경망 기법에 비해 과적합 정도가 낮음 - 예측의 정확도가 높음 - 저차원과 고차원에서 모두 잘 작동 - 비선형 데이터도 분류 모델링 가능 |
- 데이터 전처리와 매개변수 설정에 따라 정확도가 달라짐 - 예측 과정과 해석이 어려움 - 대용량 데이터에 대한 모형 구축시 속도가 느리며 메모리 할당량이 큼 |
4. k-최근접 이웃 알고리즘 (KNN)
- 어떤 범주로 나누어져 있는 데이터 셋이 있을 때, 새로운 데이터가 추가된다면 이를 어떤 범주로 분류할 것인지를 결정해 사용할 수 있는 분류 알고리즘으로 지도학습의 한 종류
1) 원리
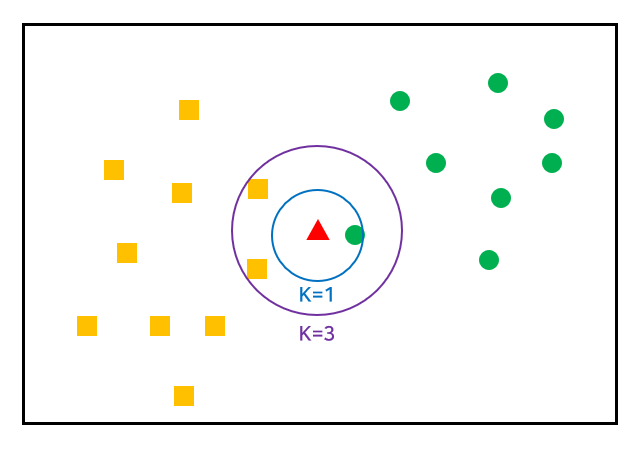
- KNN 알고리즘에서는 새로운 데이터의 클래스를 해당 데이터와 가장 가까이 있는 k개 데이터들의 클래스로 결정
- 세모의 클래스를 구분하고자 할 때 K=1이면 주변에 있는 가장 가까운 원으로 분류, K=3이면 네모로 분류됨
- 이진 분류 문제에서는 동률의 투표 문제를 피하기 위해 k의 수를 홀수로 선택하는 게 바람직함
2) k의 선택
- k의 선택은 학습의 난이도와 데이터의 개수에 따라 결정될 수 있으며 일반적으론 훈련 데이터 개수의 제곱근으로 설정
- k가 너무 클 경우, 주변에 있는 점과의 근접성이 떨어져 분류가 잘 이루어지지 않아 과소적합 문제 발생
- k가 너무 작을 경우, 주변의 다른 이웃들을 충분히 고려하지 못해 과적합 문제 발생
3) 이웃 간의 거리 계산 방법
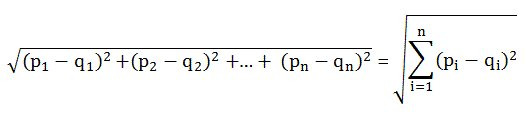
- 유클리디안 거리, 맨하탄 거리, 민코우스키 거리 등을 사용하지만 일반적으론 유클리디안 거리 사용
4) K-NN 분류 예시
새로운 객체의 데이터값 (x,y)가 주어졌다고 했을 때, 기존 객체들과의 거리를 계산해 가장 이근에 있는 데이터 k개를 파악함
5) 장단점
| 장점 | 단점 |
| - 사용이 간단 - 범주를 나눈 기준을 알지 못해도 데이터 분류가 가능 - 추가된 데이터의 처리가 용이 |
- k값의 결정이 어려움 - 수치형 데이터가 아닐 경우 유사도를 정의하기 어려움 - 이상치가 성능에 큰 영향을 미침 |
5. 나이브 베이즈 분류
1) 개념
- 데이터에서 변수들에 대한 조건부 독립을 가정하는 알고리즘
- 클래스에 대한 사전 정보와 데이터로부터 추출된 정보를 결합하고, 베이즈 정리를 이용해 어떤 데이터가 특정 클래스에 속하는지를 분류하는 알고리즘
- 텍스트 분류에서 문서를 여러 범주(스팸, 경제, 스포츠) 중 하나로 판단하는 문제에 댛나 솔루션으로 사용할 수 있음
2) 베이즈 정리
- 두 확률 변수의 사전 확률과 사후 확률 사이의 관계를 나타내는 정리
- 사건 A와 B가 있을 때 사건 B가 일어난 것을 전제로 한 사건 A의 조건부 확률을 구하고자 함
- 하지만 현재 가지고 있는 정보는 사건 A가 일어난 것을 전제로 한 사건 B의 조건부 확률, A와 B의 확률뿐
- 이때, 원래 구하고자 했던 '사건 B가 일어난 것을 전제로 한 사건 A의 조건부 확률'을 구하는 방법이 베이즈 정리
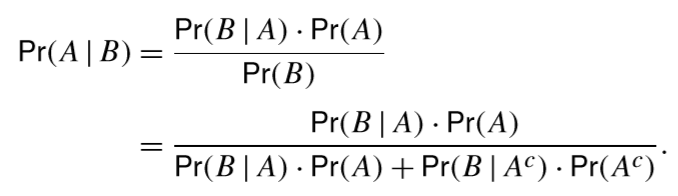
- P(A|B) = 사후 확률
- P(B|A) = 우도
- P(A) = 사전확률
3) 나이브 베이즈 분류의 계산
- 하나의 속성값을 기준으로 다른 속성이 독립적이라 전제했을 때 해당 속성 값이 클래스 분류에 미치는 영향을 측정
- 클래스 조건 독립성: 속성값에 대해 다른 속성이 독립적이라는 가정
- 조건부 확률 P(Ci | X)가 최대일 경우를 찾음
- P(Ci | X) = P(Ci) * P(X | Ci) / P(X)
6. 앙상블
- 주어진 자료로부터 여러 개의 예측모형들을 만든 후 예측모형들을 조합하여 하나의 최종 예측모형을 만드는 방법
- 학습방법이 불안전한 의사결정나무에 주로 사용
1) 배깅
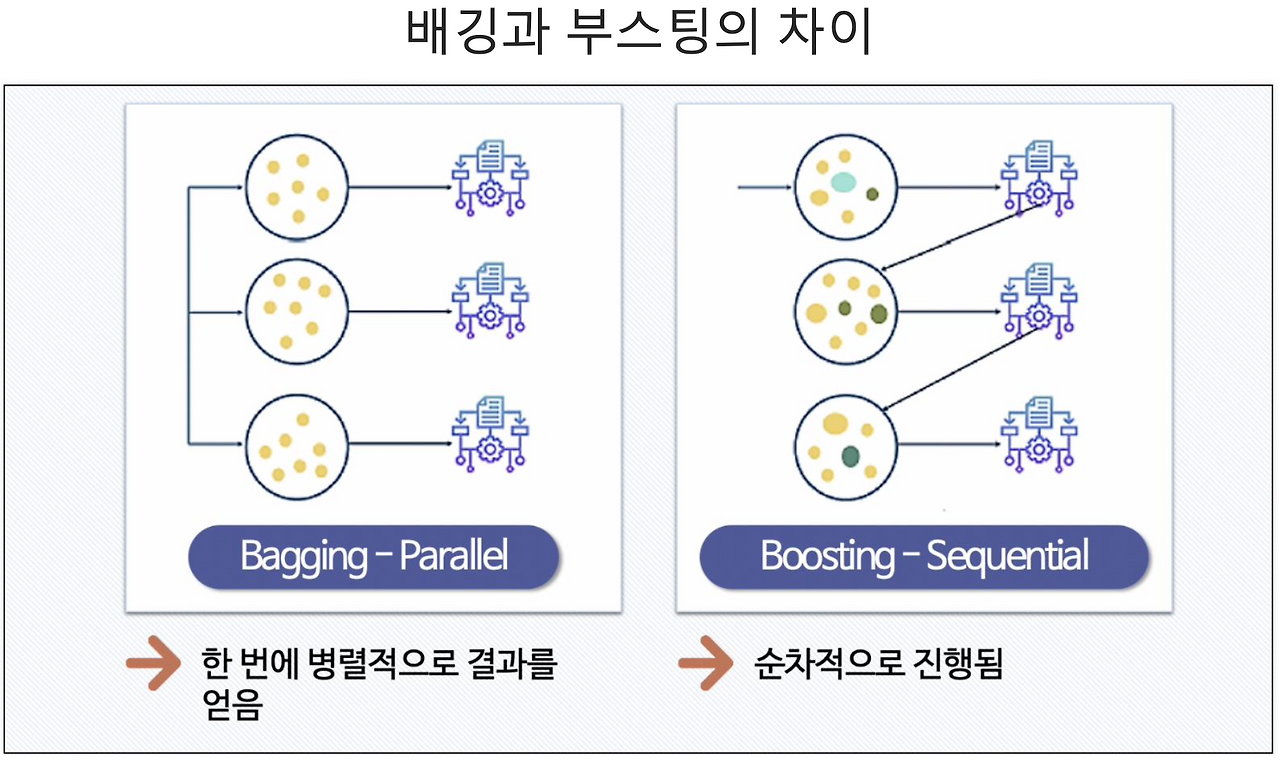
- 주어진 자료에서 여러 개의 부트스트랩 자료를 생성하고 각 부트스트랩 자료에 예측모형을 만든 후 결합하여 최종 예측 모형을 만드는 방법
- 보팅은 여러 개의 모형으로부터 산출된 결과를 다수결에 의해서 최종결과를 산정하는 과정
- 최적의 의사결정나무를 구축할 때 가장 어려운 부분이 가지치기이지만, 배깅에서는 가지치기를 하지 않고 최대로 성장한 의사결정나무들을 활용
- 훈련자료의 모집단 분포를 모르지만, 훈련자료를 모집단으로 생각하고 평균예측모형을 구하여 분산을 줄이고 예측력을 올림
2) 부스팅
- 예측력이 약한 모형들을 결합하여 강한 예측모형을 만드는 방법으로 오분류 데이터에 가중치를 부여
- Adaboost는 이진분류 문제에서 랜덤 분류기보다 조금 좋은 더 분류기 n개에 각각 가중치를 설정하고 n개의 분류기를 결합하여 최종 분류기를 만드는 방법을 제안
- 해당 방법은 훈련오차를 빠르고 쉽게 줄일 수 있고, 대부분 배깅에 비해 예측 오차가 향상됨
a. Gradient Boosting Machine (GBM)
- 오차를 미분한 Gradient를 줌으로써 모델을 보완하는 방식
- 부스팅에서 경사하강법을 이용해 최적화된 결과를 얻는 알고리즘
- 경사하강법은 손실함수의 미분값이 최소가 되도록 하는 방향을 찾아 접근하는 방식
- 장점: 일반적으로 랜덤포레스트보다 성능이 높음
- 단점: 시간이 많이 소요되며, 하이퍼 파라미터 튜닝 필요, 과적합 우려가 있어 정규화 필요, 병렬 처리 지원 x
● XGBoost
- GB 알고리즘을 분산환경에서도 실행할 수 있도록 구현해놓은 라이브러리
- 회귀, 분류 문제 모두 지원 가능하며 성능과 자원 효율이 좋음
- GBM보다 빠르며, 과적합 방지가 가능한 규제가 포함되어 있음
- 유연성이 좋아 여러 파라미터를 조절하며 최적의 모델을 만들며 다른 알고리즘과 연계가 좋음
● LightGBM
- 느리고, 하이퍼파라미터가 많다는 XGBoost의 단점을 개선
- 다른 Tree기반 알고리즘과 달리 Tree 구조가 수직으로 확장하는 leaf-wise 방식을 채택해 예측 오류 손실을 최소화
- XGBoost보다 빠르고, 대용량 데이터를 다루며, 메모리 사용량이 상대적으로 적고, 병렬 컴퓨팅 기능을 제공하고, GPU도 지원
- 하지만 적은(10,000건 이하) 데이터셋에 적용할 경우 과적합 발생이 쉬움
3) 랜덤포레스트
a. 개념
- 의사결정나무의 특징인 분산이 크다는 점을 고려해 배깅과 부스팅보다 더 많은 무작위성을 주어 약한 학습기들을 생성한 후 이를 선형 결합하여 최종 학습기를 만드는 방법
- 지도학습 알고리즘으로 다수의 의사결정트리를 사용하여 회귀의 경우엔 평균화, 분류의 경우엔 투표를 통해 결과 예측
- 수천 개의 변수를 통해 변수제거 없이 실행되므로 정확도 측면에서 좋은 성과를 보임
- 해석이 어렵지만 예측력은 매우 높음
b. 장단점
| 장점 | 단점 |
| - 간편하고 빠름 - 다중 클래스 알고리즘의 특성 - 노이즈에 민감하지 않음 - 분류 및 회귀 모두 적용 가능 |
- 매개변수를 잘못 설정하면 과적합 발생 - 메모리 사용량이 많음 - 텍스트 데이터에는 잘 작동하지 않음 |
c. 변수 중요도
- 의사결정나무를 기반으로 하는 모델은 변수 중요도 값을 제공
- 변수 중요도란 불순도를 얼마나 감소시키는지를 통해 측정되는 값
'빅데이터분석기사' 카테고리의 다른 글
| [빅분기] 10.3. 군집분석 (4) | 2025.08.28 |
|---|---|
| [빅분기] 10.2. 연관분석 (2) | 2025.08.28 |
| [빅분기] 9.6. 비모수 통계 (8) | 2025.08.27 |
| [빅분기] 9.5. 시계열 분석 (3) | 2025.08.26 |