1. 데이터 수집
1) 빅데이터 수집 기법
| 구분 | 특징 | 대상 |
| Log Aggregator | 웹 서버 로그, 웹 로그 등 각종 서비스 로그 수집 오픈 소스 기술 | 로그 데이터 수집 |
| 크롤링 | SNS, 웹, 뉴스 등 인터넷상에서 제공되는 웹 문서에 대한 정보 수집 | 웹 문서 수집 |
| 스크래핑 | 인터넷 웹 사이트에 노출되는 내용 중 특정 정보만을 추출 | 웹 데이터 수집 |
| FTP | TCP/IP 프로토콜을 이용하여 인터넷 서버로부터 각종 파일들을 송수신 | 파일 수집 |
| Open API | 오픈된 정보로부터 API를 통해 데이터를 수집 | 실시간 데이터 수집 |
| RSS | 웹상의 최신 정보를 공유하기 위한 XML 기반의 콘텐츠 배급 프로토콜 | 콘텐츠 수집 |
| Streaming | 인터넷에서 멀티미디어 데이터를 실시간으로 송/수신할 수 있는 기술 | 실시간 데이터 수집 |
| RDB Aggregator | 관계형 데이터베이스에서 정형 데이터를 수집해 HDFS나 NoSQL에 저장하는 | RDB 기반 데이터 수집 |
a. 정형 데이터 수집 기법
ETL(Extract Transform Load):
- 수집한 데이터를 데이터 웨어하우스와 데이터 마트로 이동시키기 위해 사용하는 기술
FTP(File Transfer Protocol):
- TCP/IP 프로토콜을 통해 원거리에 있는 서버와 클라이언트 사이의 파일 전송을 위한 프로토콜
API(Application Programming Interface):
- 응용 프로그램에서 사용하 ㄹ수 있도록 운영 체제나 프로그래밍 언어가 제공하는 기능을 제어할 수 있게 만든 인터페이스
Sqoop:
- MySQL 같은 관계형 데이터베이스와 아파치 하둡 간의 대용량 데이터들을 효율적으로 변환하여 주는 명령 줄 인터페이스 애플리케이션
b. 반정형 데이터 수집 기법
Scribe
- 페이스북에서 개발한 실시간 스트리밍 로그 데이터 수집 애플리케이션
- 설치 및 구성이 용이
Flume
- 분산 환경에서 대량의 로그 데이터를 효과적으로 수집하고 합친 후 효율적으로 전송할 수 있는 서비스
- 클러스터 환경에서 장애에 쉽게 대처 가능하고 로그 유실에 대한 신뢰 수준을 상황에 맞게 변경함으로써 신뢰성 있는 데이터 수집이 가능
Chukwa
- 분산된 노드들의 다양한 로그 데이터를 수집하고 수집된 데이터를 HDFS에 저장하고 분석하기 위한 시스템
c. 비정형 데이터 수집 기법 (가장 흔히, 크롤링)
스크래피
- Python으로 작성된 오픈소스 웹 크롤링 프레임워크
- 대규모 크롤링 프로젝트 개발에 용이
아파치카프카
- 실시간 데이터 피드를 관리하기 위해 높은 처리량, 낮은 지연 시간을 지닌 플랫폼 제공
- 스트리밍 데이터 처리를 위한 기업 인프라를 위한 고부가 가치를 제공
웹 로봇
- 사람과의 상호작용 없이 연속된 웹 트랜잭션들을 자동으로 수행하는 소프트웨어 프로그램
- 주로 검색엔진에서 활용
웹 크롤러
- 조직적이고 자동화된 방법으로 월드와이드웹(www)을 탐색하는 컴퓨터 프로그램
- 검색엔진에서 주로 사용
2) 데이터 소스에 따른 수집 방법
내부데이터는 ETL 방식으로 데이터 수집
- Extraction(추출), Transform(변환), Loading(적재)
외부 데이터는 크롤링으로 수집
3) 빅데이터 수집 시스템의 요건
a. 확장성: 데이터 수집의 대상이 되는 서버는 충분한 확장이 가능
b. 안정성: 수집된 데이터는 유실, 변경, 삭제되지 않고 안정적으로 저장
c. 유연성: 다양한 데이터 원천의 여러 포맷에 적용할 수 있도록 변경이 용이
d. 실시간성: 수집된 데이터는 실시간으로 반영
2. 데이터 유형 및 속성 파악
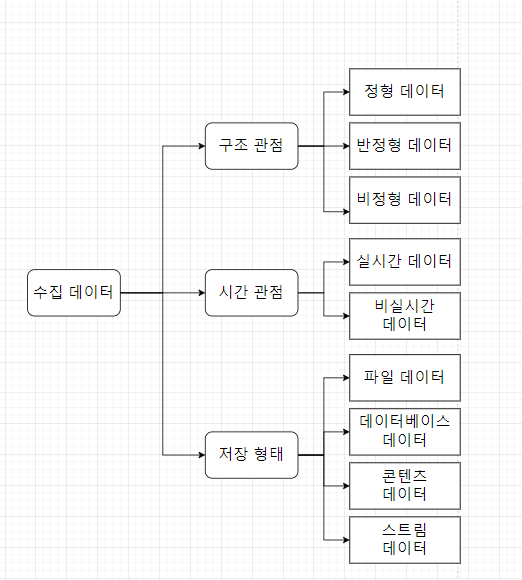
1) 수집 대상에 따른 데이터 유형
2) 일반적인 데이터의 특징
| 구분 | 정성적 데이터 | 정량적 데이터 |
| 형태 | 비정형 데이터 | 정형/반정형 데이터 |
| 특징 | 객체 하나에 함의된 정보를 가짐 | 속성이 모여 객체를 이룸 |
| 구성 | 언어, 문자 | 수치, 도형, 기호 |
| 저장 형태 | 파일, 웹 | 데이터베이스, 스프레드시트 |
| 소스 위치 | 외부 시스템 | 내부 시스템(주로 RDBMS) |
정성적 데이터의 수집 방법 : FGI(Focus Group Interview) 등
정량적 데이터의 수집 방법: CLT 조사(Central Location Test), 갱 서베이 등 (조사 대상자에게 직접 조사)
즉, 심층 면접 결과는 정성적 데이터, 간단한 질문지 조사 결과 등은 정량적 데이터
3) 구조 관점의 데이터 유형
| 유형 | 정형 데이터 | 반정형 데이터 | 비정형 데이터 |
| 설명 | 미리 정해 놓은 형식과 구조에 따라 저장되도록 구성된 데이터 | 데이터의 형식과 구조가 변경될 수 있는 데이터 | 정의된 구조가 없는 데이터 |
| 특징 | 정형화된 스키마를 가짐 일관성 있는 값과 형식을 가짐 |
정형화된 스키마를 가짐 값과 형식에서 일관성이 없음 |
스키마가 없음 |
| 종류 | 관계형 데이터베이스 스프레드시트 |
XML, HTML, 웹 로그 JSON, RSS |
SNS, NoSQL 텍스트, 이미지, 오디오, 비디오 |
| 수집 기술 | ETL, FTP, Open API, Sqoop | 크롤링, RSS, FTP Open API, Flume, Scribe, Chuckwa |
크롤링, RSS, FTP Open API, Streaming, Scrapy, Apache Kafka |
| 데이터 수집 난이도 | 하 | 중 | 상 |
| 잠재 가치 | 낮음 | 정형 데이터보다 높음 | 가장 높음 (수집 주체에 의해 분석이 선행되었기 때문) |
4) 시간 관점의 데이터 유형
| 유형 | 실시간 데이터 | 비실시간 데이터 |
| 설명 | 생성된 이후 즉시 처리해야만 효용가치가 있는 데이터 (현재) |
수 시간 또는 수 주 이후에 처리되어야 의미가 있는 데이터 (과거) |
| 종류 | 센서 데이터, 시스템 로그, 네트워크 장비 로그 | 통계, 웹 로그, 구매 정보, 서비스 로그 |
5) 저장 형태 관점의 데이터 유형
| 유형 | 파일 데이터 | 데이터베이스 데이터 | 콘텐츠 데이터 | 스트림 데이터 |
| 설명 | 파일 형식의 데이터 | 데이터베이스에 저장된 데이터 | 개별적으로 데이터 객체로 구분될 수 있는 미디어 데이터 | 네트워크를 통해 실시간으로 전송되는 데이터 |
| 종류 | 시스템 로그, 서비스 로그 | NoSQL, RDB | 텍스트, 이미지, 비디오 | 센서 데이터 |
3. 데이터 변환
1) 데이터 전/후처리 단계
a. 데이터 전/후처리 개념
- 데이터 전처리: 수집된 데이터를저장소에 적재하기 위해 데이터를 변환하는 것
- 데이터 후처리: 저장된 데이터를 분석에 용이하도록 변환, 통합, 축소 등의 기술을 사용하여 가공하는 단계
2) 데이터 변환 기술
| 기술 | 내용 |
| 평활화 | 잡음을 제거하기 위해 추세에서 벗어나는 값을 변환함 (구간화, 군집화) |
| 집계 | 다양한 차원의 방법으로 데이터를 요약 (ex. 여러 개의 표본을 하나의 표본으로 줄임) |
| 일반화 | 특정 구간에 분포하는 값으로 스케일을 변화시킴 (범용 데이터에도 적용시킬 수 있게) |
| 정규화 | 데이터가 정해진 구간 내에 포함되도록 함 (범위나 분포를 일정한 기준으로 맞춤. ex) 0~1 범위 |
| 속성 생성 | 데이터 통합을 위해 새로운 속성 및 특징을 만듦 |
3) ETL 프로세스
a. ETL 개념
- ETL(Extraction, Transformation and Load)은 데이터의 이동 및 변환 절차와 관련된 용어
- 서로 다른 시스템 간의 데이터 공유를 위한 가장 일반적인 형태 (기존의 시스템 환경으로부터 빅데이터를 추출하여 비즈니스 데이터로 변환)
- 데이터 원천으로부터 추출된 데이터를 운영데이터 스토어, 데이터 웨어하우스, 데이터 마트 등에 적재
- 데이터의 이동 및 변환이 주된 목적
b. ETL의 역할
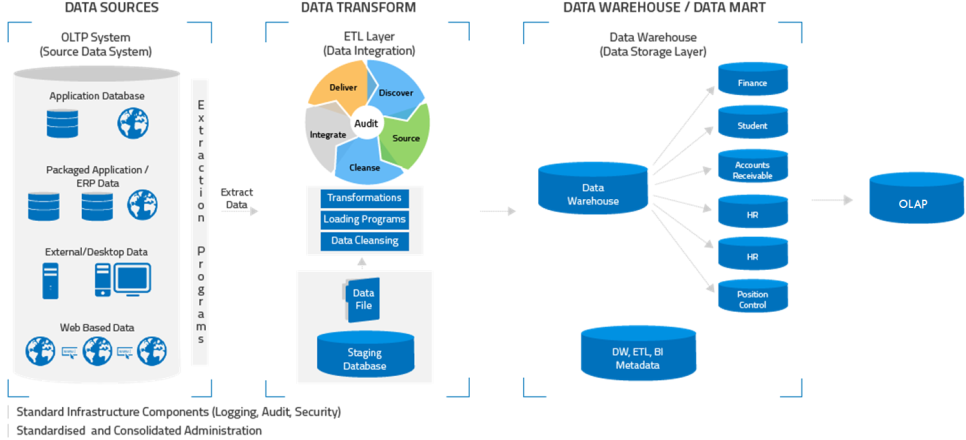
- 조직내 데이터 웨어하우스를 기반으로 데이터 관리가 이루어질 때, 크게 데이터의 수집/관리/분석의 역할로 나뉘며 각 역할을 위해 3개의 레이어로 구성됨
- 소스 레이어: 데이터 수집
- DW 레이어: ETL 과정을 거쳐 데이터 변환시킨 후 데이터 웨어하우스에 저장하기까지의 레이어
- 분석 레이어: 데이터 웨어하우스를 통해 조직 내 데이터를 체계적으로 관리하며 데이터 분석도 이루어지는 레이어
4) 데이터 변환 절차
- 비정형 데이터를 정형 데이터로 변환하여 저장할 때 관계형 DBMS를 가장 많이 사용
- 비정형 또는 반정형 데이터를 정형 데이터로 변환하는 과정은 다음과 같음
1) 데이터 구조 정의: 데이터들의 속성 구조 확인
2) 수행 코드 정의: 정보 구조를 확인하고, 필요 데이터만을 추출
3) 프로그램 작성
4) DB 저장
4. 데이터 비식별화
1) 데이터 보안
a. 데이터 보안 적용 기술
- 사용자 인증 (ID/Password, OTP 등)
- 접근 제어
- 암호화
- 개인 정보 비식별화
- 개인 정보 암호화
2) 비식별화 개념
- 데이터 내에 개인을 식별할 수 있는 정보가 있는 경우 이의 일부 또는 전부를 삭제하거나 일부를 속성 정보로 대체하여 처리함으로써 다른 정보와 결합하여도 특정 개인을 식별하기 어렵도록 하는 조치
- 사전 검토 -> 비식별 조치 -> 적정성 평가 -> 사후 관리의 가이드라인
3) 비식별화 대상 및 기준
a. 비식별화 적용 대상
- 그 자체로서 개인을 식별할 수 있는 정보(이름, 주민등록번호) + 다른 정보와 결합하여 개인을 알아볼 수 있는 정보(성별, 나이, 고향, 국적, 흡연 여부 등)
b. 비식별화 적용 시기
- 빅데이터 수집 및 활용 단계에서 개인 정보가 식별되는 경우
c. 비식별화 적용 시기의 예시
- 개인 정보의 수집 및 저장
- 개인 정보를 포함한 데이터의 활용
- 다른 기관 및 조직과의 정보 공유
4) 비식별화 기술
a. 식별자 처리를 통한 식별 방지 기술
- 가명처리: 식별할 수 없는 다른 값으로 대체
- 총계처리: 평균, 합 등의 통계값을 적용해 특정 개인을 판단할 수 없게 함
- 데이터 삭제: 특정 데이터 값 삭제
- 데이터 범주화: 해당 그룹의 대표 값으로 변환하거나, 구간값으로 변환(홍길동, 35세 -> 홍씨, 30~40세)
- 데이터 마스킹: 개인 식별 정보에 대해 대체값 변환(공백, *, 노이즈 등)
b. 프라이버시 모델 기반 추론 방지 기술
k-익명성:
-특정인에 대해 비식별 조치
-데이터 집합에 같은 값을 k개 이상 집어넣어 다른 정보들을 조합해 특정인을 추론할 수 없게끔 함
l-다양성:
- 특정인 추론이 불가능한 상황이더라도 민감한 정보의 다양성을 높임
- 각 블록은 적어도 l개의 다양한 민감정보를 가지면서, 다양성의 부족으로 인한 공격 가능성을 낮춤
t-근접성:
- l-다양성을 만족해도 발생할 수 있는 민감정보의 분포 차이에 따른 사생활 정보 노출에 대응 가능
- 모집단과 민감한 정보의 분포 차이를 t 이하로 만듦
정리:
- 공개된 데이터의 취약점인 연결공격을 k-익명성으로 방어
- k-익명성의 취약점인 동질성 공격을 l-다양성으로 방어
- l-다양성의 취약점인 쏠림/유사성 공격을 t-근접성으로 방어
c.익명성 검증 조건: m-유일성
- 모든 부분속성집합에 대해 유일성이 존재하지 않도록 함 -> 특정한 개인을 식별하는 것이 불가능
d. 비식별화에서 사용되는 주요 개념
- 식별자: 개인을 식별할 수 있는 속성(주민번호, 전화번호, 이름 등)
- 준식별자: 자체로는 식별자가 아니지만, 다른 데이터와의 결합을 통해 특정 개인을 추론하는 데 사용될 수 있는 속성(몸무게, 혈액형 등)
- 민감정보: 개인의 사생활을 드러낼 수 있는 속성(예금 잔고, 병명, 카드 결제액)
5. 데이터 품질 검증
1) 데이터 품질 관리의 개념
a. 데이터 품질
- 데이터가 조직 구성원, 고객 등 데이터 이용자의 만족을 충족시킬 수 있는 수준 (사용자에게 유용한 가치 제공)
b. 데이터 품질 관리
- 조직에서 보유한 DB에 저장되어 있는 데이터를 수집/처리/보관/분석하는 동안 무결성을 보장하는 비즈니스 프로세스
2) 데이터 품질 관리의 중요성
- 데이터 분석 결과의 신뢰성 확보
- 일원화된 프로세스
- 데이터 활용도 향상
- 양질의 데이터 확보
3) 데이터의 품질 기준
a. 정형 데이터의 품질 기준
- 완전성
- 유일성 (중복 x)
- 유효성 (정해진 범위 및 도메인)
- 일관성
- 정확성
b. 비정형 데이터의 품질 기준
- 신뢰성
- 기능성
- 효율성
- 사용성
- 이식성
4) 품질 진단 방법
a. 프로파일링
- 값 진단: 데이터 값 자체 오류를 분석
- 구조 진단: 논리적 데이터 구조의 오류로 인한 일관성, 정합성 등을 확보하지 못하는 결함을 분석
b. 체크리스트
- 설문 또는 인터뷰 등을 통해 데이터 품질 관리 수준을 체크
c. 업무규칙 진단
- 법, 규정에 정의된 업무기준(산출식)에 근거하여 데이터가 관리되고 있는지 진단
d. 비정형 실측
- 문서, 이미지, 동영상 등 정형화되어 있지 않은 정보를 사람이 직접 확인을 통하여 오류 여부를 진단
'빅데이터분석기사' 카테고리의 다른 글
| [빅분기] 4.1. 데이터 전처리 (3) | 2025.08.17 |
|---|---|
| [빅분기] 3.2. 데이터 적재 및 저장 (5) | 2025.08.17 |
| [빅분기] 2.2. 분석의 유형 (0) | 2025.08.15 |
| [빅분기] 2.2. 분석 작업 계획(1) (3) | 2025.08.15 |

