1. 표본추출
1) 표본 추출 과정
a. 모집단 결정 (연구대상, 표본단위, 연구범위, 기간 등을 명확히 결정)
b. 표집틀 선정 (표본을 추출하게 될 표집틀 선정)
c. 표본추출방법 결정
d. 표본의 크기 결정
e. 표본 추출
f. 표본조사 결과 발표에 포함되어야 할 사항 (모집단의 정의, 표본의 크기, 조사방법, 조사기간, 표본 추출 방법)
2) 표본추출 방법 - 확률표본추출법
| 기준 | 확률표본추출 | 비확률표본추출 |
| 연구대상이 표본으로 추출될 확률 | 동등함, 알려져 있을 때 | 동등하지 않음, 알려져 있지 않음 |
| 표본 추출 | 무작위적 표집 | 인위적 표집 |
| 표본의 통계치로 모수 추정 | 편의가 없음 | 편의가 있음 |
| 모수 추정 가능성 | 추정 가능 | 추정 불가능 |
| 오차 측정 가능성 | 측정 가능 | 측정 불가능 |
| 시간과 비용 | 많이 소요됨 | 적게 소요됨 |
| 모집단의 규모와 성격 | 명확히 규정 | 불명확 또는 불가능 |
a. 단순랜덤추출법
- 모집단이 매우 큰 경우 선택된 원소를 찾기 어렵다는 단점도
b. 계통추출법(Systematic Sampling)
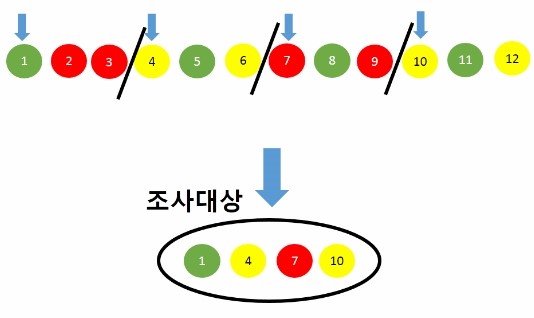
- 번호를 부여한 샘플을 나열하여 k개씩 n개의 구간으로 나누고, 첫 구간에서 하나를 랜덤하게 출발점으로 정한 다음, 그 점으로부터 매번 k번째 떨어진 간격에 위치하는 원소를 추출
- 일반적으로 모집단 크기가 N, 표본 크기가 n인 계통 표본에서는 k를 N/n 이하가 되도록 정해줌, 위의 그림에서 12개 중 4개를 뽑는다고 정했을 땐 각 구간마다 3개씩 배치하는 것
c. 집락추출법(Cluster Random Sampling)
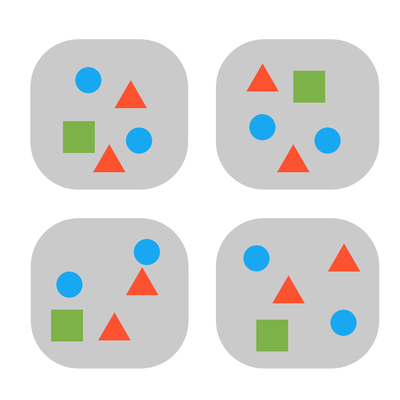
- 모집단이 몇 개의 집단이 결합된 형태로 구성되어 있고, 각 집단 내부에서는 원소들에게 일련번호를 부여할 수 있는 경우 이용됨
- 각 집단을 집락으로 구분하며, 일부 집락을 랜덤으로 선택하고 선택된 각 집락 내에서 표본을 임의로 선택
- 집단 내: 이질적, 집단 간: 동질적
d. 층화추출법(Stratified Random Sampling)
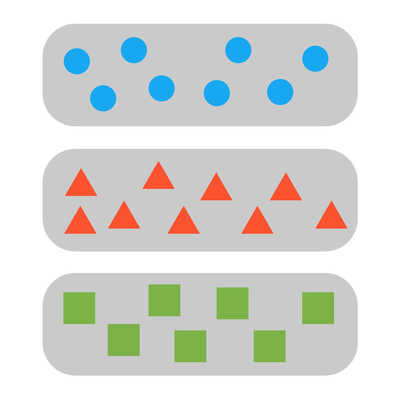
- 이질적인 원소들로 구성된 모집단에서 각 계층을 고루 대표할 수 있도록 표본을 추출하는 방법
- 모집단을 서로 겹치지 않는 층들로 나누고 각 층에서 단순 확률 표본을 추출
- 동그라미, 세모, 네모가 각각 4000, 3000, 3000개라면 각각 40, 30, 30개씩 뽑음
- 집단 내: 동질적, 집단 간: 이질적
3) 표본추출 방법 - 비확률 표본추출법
- 모집단으로부터 원소들을 추출하는 과정에서 랜덤하게 추출하지 않는 방법
- 분석 결과의 일반화에 제약이 있음, 반면 비용이 적어 실행하기 쉽다는 장점이 있음
a. 편의 표본추출
- 정해진 크기의 표본을 선정할 때까지 조사자 임의대로 원소들을 표집
b. 유의 표본추출
- 연구자의 의도에 따라 특정 대상을 표본으로 추출
c. 지원자 표본추출
- 메일이나 광고지 등을 통해 희망자들을 대상으로 표본 추출
d. 할당 표본추출
- 인구통계학적 특성이나 거주지와 같은 모집단의 속성을 미리 파악할 수 있을 때 각 속성의 구성 비율을 고려해 추출
- 층화추출과 비슷하지만, 표집틀이 없다는 차이
e. 눈덩이 표본추출
- 소수 참여 대상자로부터 또 다른 여러 명의 참여 대상자를 계속적으로 소개받는 식으로 표본을 누적
2. 확률 분포
1) 확률
a. 독립과 상호 배반
독립은 두 사건이 서로 영향을 주지 않는 것, 상호 배반은 두 사건이 동시에 일어날 수 없다는 것을 의미 그렇기에 둘은 동시에 충족될 수 없음
b. 베이즈 정리
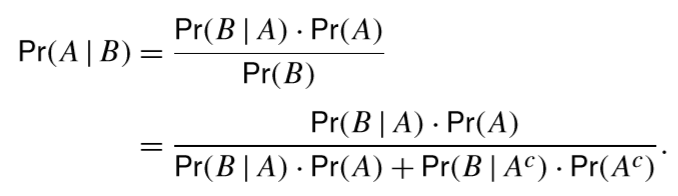
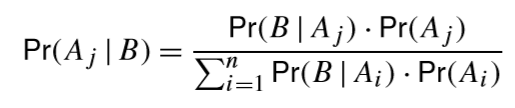
- 사전확률로부터 사후확률을 구할 때 사용
- 다른 사건 B가 일어났을 때 이 사건이 Ai에서 일어날 확률
2) 확률변수
a. 확률변수의 개념
- 확률적인 결과에 따라 결과값이 바뀌는 변수 (확률변수란 정의역이 표본 공간이고 치역이 실수값인 함수)
b. 연속형 확률변수
- 실수 구간에서 0이 아닌 확률을 갖는 확률 변수
- 연속형 확률변수 X의 확률함수를 f(x)라고 할 때, f(x)는 확률 밀도함수(pdf)라고 부름
c. 누적 분포 함수
- 특정값 a에 대하여 확률변수 X가 X <= a인 모든 경우의 확률의 합
3) 확률분포 - 이산형 확률분포
a. 베르누이 확률분포
- 결과가 2개만 나오는 경우(동전 던지기)
- 실험의 결과가 성공과 실패의 두 가지 상호 배반적 사건으로 나누어지는 분포
- E(x) = p, V(x) = p(1-p)
b. 이항분포

- 베르누이 시행을 n번 반복했을 때 k번 성공할 확률
- 시행횟수 n이 커지면 커질수록, p가 0이나 1에 가깝지 않을수록 이항분포는 정규분포에 가까워짐
- E(x) = np, V(x) = np(1-p)
c. 기하분포
- 성공확률이 p인 베르누이 시행에서 처음 성공이 일어날 때까지 반복한 시행횟수를 X라고 할 때, X는 성공확률이 p인 기하분포를 따른다고 하고, X~Geo(p)로 나타냄
- 단 한번의 성공을 위해 실패를 거듭해야 하는 경우 기하 분포를 사용
- E(x) = 1/p, V(x) = 1-p / p^2
- k번 시행에서 시행 횟수에 대한 확률 질량 함수 P(X=k) = (1-p)^k-1 * p
- 첫번째 성공까지 시행한 실패 횟수에 대한 확률 질량 함수 P(Y=k) = (1-p)^k * p
- ex) 어느 콜센터에 전화가 연결될 확률이 p = 0.05일 때, 5회 안에 전화가 연결될 확률은?
5회 안에 전화가 연결된다는 건 4번은 실패하고 5번째에 성공한다는 의미
이때 시행 횟수 k = 5, p = 0.05
d. 음이항분포
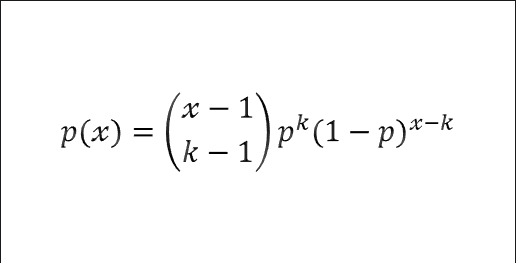
- 기하 분포를 확장한 것으로, 성공확률이 p인 베르누이 시행에서 k번 성공할 때까지 반복한 시행횟수 또는 실패횟수에 대한 확률
- x = 시행횟수, k = 성공 횟수
- ex) 어느 야구 선수가 안타를 칠 확률은 0.25이다. 이 선수가 7번째 타석에서 3번째 안타를 칠 확률을 구하시오.
성공횟수는 3이고, 실패횟수는 4
즉, 6C2 * 0.25^3 * 0.75^4
마지막 시행은 성공으로 확정 지은 후, 성공 이전의 앞선 6번의 시행에서 2번 성공했다는 해석이 가능할 것 같다 (6C2)
그 뒤의 곱셈은 성공 확률과 실패 확률을 각각 곱해주면 된다
e. 포아송분포
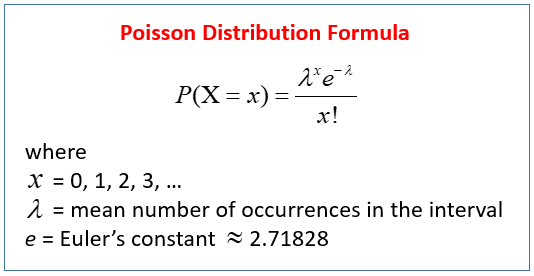
- 시간과 공간 내에서 발생하는 사건의 발생횟수에 대한 확률분포
- λ (람다): 정해진 시간 안에 어떤 사건이 일어날 횟수에 대한 기대값
- x = 사건이 일어난 수
- 이항 분포와 비슷하지만, n이 크면서 p가 매우 작은 경우에 사용
- E(x) = V(x) = λ
- ex) 한 실험에서 1/1000초당 통과하는 방사선 물질의 평균 수가 4라고 하자. 어느 주어진 1/1000초에서 6개의 방사성 물질이 통과할 확률은?
λ = 4, x = 6이기 때문에 (4^6 * e^-4) / 6! = 0.1043
f. 초기하분포
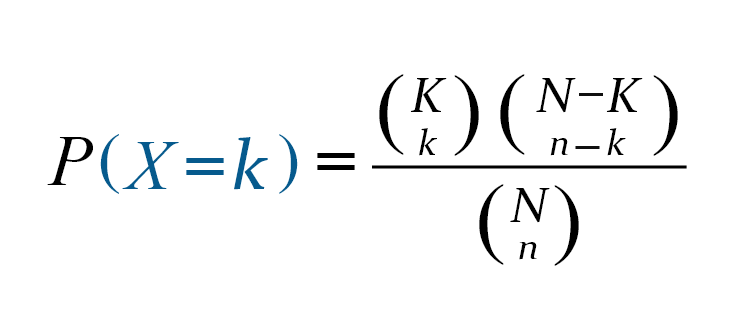
- N개의 유한모집단에서 n개의 표본을 비복원추출할 때, k번 성공할 확률
- 빨간색 공 10개와 파란색 공 6개가 들어있는 상자에서 5개의 공을 뽑는다고 가정했을 때, 그 중 빨간색 공의 개수에 대한 확률
- 이때 N = 16, n = 5(뽑을 공의 수), K =10(빨간색 공의 수), k(뽑을 공 중 빨간색 공의 수)
- 빨간색 공이 3개 나왔다면, 10C3 * 6C2 / 16C5
- E(x) = n * K/N
- V(x) = n * K/N * (1- K/N)
g. 다항분포
- 이항분포를 확장한 것으로 세가지 이상의 결과를 가지는 반복 시행에서 발생하는 확률 분포
- ex) 100개의 구슬 중 투명이 20, 검은색이 30, 하얀 구슬이 50개이고, 이 주머니에서 복원추출로 구슬을 10번 뽑을 때, 투명 구슬이 5개, 검은색 구슬이 2개, 하얀 구슬이 3개 나올 확률은?
(10! / 5! * 2! * 3!) * 0.2^5 * 0.3^2 * 0.5^3
'빅데이터분석기사' 카테고리의 다른 글
| [빅분기] 6.2. 추론통계 (6) | 2025.08.23 |
|---|---|
| [빅분기] 6.1. 기술통계 (2) (4) | 2025.08.22 |
| [빅분기] 5.2. 고급 데이터 탐색 (1) | 2025.08.21 |
| [빅분기] 5.1. 데이터 탐색 (0) | 2025.08.21 |
