- 추론통계는 표본에서 얻은 통계량을 기초로 모집단의 특성인 Parameter를 추측하는 것
1. 점 추정
- 확률표본의 정보를 이용하여 모수에 대한 특정값을 지정하는 것을 말함
- 즉, '모수가 특정한 값일 것이다'라고 선언하는 것
1) 모평균 µ의 추정량
- 가장 바람직한 추정량이란 추정량의 분포에서 분포의 중심이 추정하고자 하는 모수이고(불편성), 붙포의 흩어진 정도가 작은(효율성) 추정량을 말함, 이를 최소분산불편추정량이라고 함
2) 모분산 σ^2의 추정량
- 표본분산 S^2를 구할 때 자유도 n-1로 나누면 모분산 σ^2의 불편추정량이지만, 최소분산을 가지진 않음
- 그냥 표본 수인 n으로 나누면 최소분산을 가지지만, 일반적으론 자유도를 고려한 위의 방법을 모분산의 추정량으로 씀
3) 모비율 P의 추정량
- n명을 표본으로 추출해 투표를 실시한다고 할 때, 표본은 (X1,X2, ..., Xn)으로 표현됨
- 이때 Xi는 다음과 같이 표현될 수 있음
- Xi = {
- 1, i번째 사람이 찬성인 경우
- 0, i번째 사람이 반대인 경우
}
- 이때 X를 Σ Xi와 같이 정의하면 확률변수 X는 표본으로 추출된 n명 중 찬성하는 사람의 수를 의미하므로, 모집단에서의 찬성률 P의 추정량은 P_hat = X/n으로 구할 수 있음
2. 구간 추정
- 모수가 특정할 값일 것이다라고 선언하는 점추정은 사실상 추정이 얼마나 정확한지에 대한 파악이 불가능함
- 구간추정이란 확률로 표현된 믿음의 정도 하에서 모수가 특정한 구간에 있을 것이라고 선언하는 것
- 구간추정을 위해선 아래의 전제가 주어져야함
● 추정량의 분포에 대한 전제
- 표본평균, 표본분산, 표본비율이 어떤 분포를 가지는지
● 구해진 구간 안에 모수가 있을 가능성의 크기
- 신뢰수준 / 신뢰구간
1) 단일 모수의 신뢰구간 추정
a. 모평균 µ의 신뢰구간
- µ의 추정량은 표본평균 X_bar
● 모분산 σ^2이 알려져 있는 경우
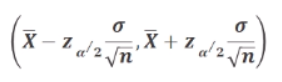
- 모평균 µ의 (1-a) * 100% 신뢰구간은 다음과 같음
- 90, 95, 99%에서 Z값은 각각 1.645, 1.96, 2.57이고 이를 각 신뢰수준 하에서의 신뢰계수라고 함
● 모분산 σ^2이 알려져 있지 않으며 n>30인 경우
- 윗 공식에서 σ를 표본 표준편차인 S로 대체함
- 이럴 경우, 통계량 T는 표준정규분포가 아닌, 자유도가 n-1인 t-분포를 따름 하지만, n>30일 경우, t-분포가 Z분포와 근사적으로 동일하다고 할 수 있으므로, 기존과 동일한 방법으로 구함
● 모분산 σ^2이 알려져 있지 않으며 n<30인 경우
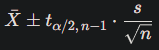
b. 모비율 P의 신뢰구간
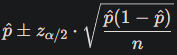
- 모비율 P의 추정량은 표본비율 P_hat
- P_hat의 평균과 분산은 각각
- E(p_hat) = P
- Var(P_hat) = P(1-P)/n
- 중심극한정리에 의해 표본분포 P_hat의 분포는 근사적으로 표준정규분포가 됨
c. 모분산 σ^2의 신뢰구간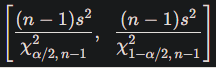
2) 두 모수 차이의 신뢰구간 추정
- 두 모수의 차이에 대한 추정은 두 집단이 서로 독립이라는 전제조건이 필요
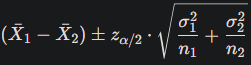
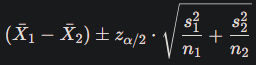
a. 두 모평균의 차이 µ1 - µ2의 신뢰구간
- 두 모평균의 차이의 추정량은 두 표본평균의 차이 X1_bar - X2_bar
- 두 모평균 차이의 신뢰구간은 X1_bar - X2_bar의 표본 분포를 이용
● 두 모분산 σ^2(1), σ^2(2)를 알고 있는 경우
● 두 모분산을 알지 못하는 경우(대표본)
b. 두 모비율의 차이 P1 - P2의 신뢰구간
- 두 모비율의 차이 P1 - P2의 추정량은 두 표본 비율의 차이 P1_hat - P2_hat
- 두 표본이 모두 독립 표본이고, np>=5 , n(1-p) >=5라는 전제가 필요
- 해당 조건이 만족되면 추정량의 표본분포는 정규분포를 따름

'빅데이터분석기사' 카테고리의 다른 글
| [빅분기] 7.1. 분산분석 (0) | 2025.08.23 |
|---|---|
| [빅분기] 6.2. 추론통계 (2) (7) | 2025.08.23 |
| [빅분기] 6.1. 기술통계 (2) (4) | 2025.08.22 |
| [빅분기] 6.1. 기술통계 (1) (4) | 2025.08.21 |