1. 데이터 모델 구축 기법
1) 통계 분석
| 회귀분석 | - 종속변수에 대한 독립변수의 선형 함수 관계로부터 새로운 값에 대해 종속변수의 값을 예측 - 특정 예측변인들이 하나의 결과변인에 미치는 인과성을 밝힐 때에도 사용 가능 |
| 로지스틱 회귀분석 | - 설명변수값이 주어졌을 때 목표변수값이 특정 부류에 속할 확률이 로지스틱 함수 형태를 따름 - 개별 관측치들이 어느 집단에 분류되는지 예측 |
| 판별분석 | - 종속변인이 둘 혹은 그 이상의 집단으로 구성되어 있을 때 여러 개의 독립변인으로 집단 관측치를 판별/예측 |
| 주성분 분석 | - 데이터에 여러 변수들이 있을 때 서로 상관관계가 높은 변수들의 선형결합으로 만들어진 '주성분'이라는 변수를 만들어 변수들을 요약하고 축소 |
2) 데이터 마이닝
- 방대한 데이터를 다양한 관점에서 분석하여 숨어있던 패턴과 상관성을 통계적 기법으로 식별해내 가치를 부여하는 것
- 숫자가 아닌 데이터도 취급하기에 통계분석과 구분됨
- 데이터 마이닝의 품질은 입력된 데이터의 품질에 따름
| 분류 | 다수의 속성을 가지는 개체를 사전에 정의된 그룹이나 범주 중의 하나로 분류하기 위해 사용 |
| 예측 | 미래에 예상되는 결과를 예측하기 위해 사용 |
| 연관 | 일련의 거래 또는 사건들 간의 규칙을 발견하여 조건과 반응의 형태로 분석 결과의 연관성을 파악 |
| 군집화 | 주어진 데이터들의 특성을 고려해 비슷한 특성을 가진 데이터들을 소그룹으로 묶음 |
분류 - 로지스틱, 서포트 벡터 머신, K-최근접 이웃, 인공 신경망, 의사결정 나무
예측 - 회귀분석, 시계열 분석, K-최근접 이웃, 인공 신경망, 의사결정 나무
연관 - 연관성 분석, 순차패턴 분석
군집화 - 군집 분석, K-means, 기대최대화
3) 머신러닝
- 데이터 마이닝이나 기타 학습 알고리즘을 사용해 지식을 추출하고 이를 경험 기반으로 삼아 비슷한 상황의 미래 사건의 결과를 예측하는 컴퓨터 프로그램
- 데이터 마이닝과 유사하지만, 기계가 데이터 모델의 매개 변수를 자동으로 학습한다는 점에서 차이가 있음, 따라서 경험을 축적하며 작업 성능이 점차 향상됨
a. 지도학습
- 입력 데이터와 원하는 출력값을 모두 제공하면서 기계를 훈련시키는 방법
- 훈련 데이터를 통하여 예측하고자 하는 반응 변수를 이용하여 새로운 데이터의 목적변수값을 추정하거나 분류
- 입력한 데이터가 많을수록 기계의 인식 정확도가 높아지므로 많은 학습 데이터가 필요하며, 훈련 과정에서 사람이 일일이 예측이 옳았는지 확인해야함
| 분류 | - 새로운 메일이 들어올 때 스팸메일인지 아닌지 분류 - 텍스트 분류를 통해 뉴스 기사를 분류 - X-Ray 사진에서 양성과 음성으로 암 진단 |
| 예측 | - 학생들의 모의고사 시험점수 등의 정보를 입력해 수능 점수 예측 - 주식 데이터를 이용한 향후 주가 예측 |
b. 비지도학습
- 자율 학습이라고도 하며, 데이터에 표식(라벨)이 붙어 있지 않은 경우로, 학습 데이터 없이 입력 데이터만을 이용하여 학습
- 반응변수에 대한 정보 없이 학습하는 형태이기에 데이터 속에 어떤 의미가 숨겨져 있는지 정확히 모르는 경우에 사용
- 사전 정보가 없는 상태에서 현상을 이해하거나 내재하는 특징 도출에 활용
| 군집 | - 홈페이지 이용 고객의 소비 패턴에 따른 고객 그룹화 |
| 연관규칙 | - 바베큐 소스, 스테이크 구매 사이의 연관성을 밝혀 이들을 가까운 진열대에 진열 |
| 차원축소 | - 주성분 분석, 요인분석, 커널 PCA |
c. 강화학습
- 주어진 입력값에 대한 출력값의 정답이 주어지지 않은 상태에서 일련의 행동의 결과에 대한 보상이 주어지게 되며, 시스템은 선택 가능한 행동들 중 보상을 최대화하는 행동 혹은 행동 순서를 선택하며 학습을 진행
- 경험과 시행착오를 통해서 얻어진 데이터를 기반으로 알고리즘이 모델을 지속적으로 개선하는 방식
- 과거에 효과가 있던 방법과 해보지 않았던 새로운 방법을 섞어 시도할 수 있다는 장점
- ex) Q-러닝, 시간차 학습
4) 비정형 데이터 분석
- 인공지능 분야에서 인간의 학습을 모델링한 것으로 빅데이터 분석을 포함한 패턴 인식 등 다양한 분야에서 많이 사용
a. 비정형 데이터
● 텍스트 마이닝
- 비정형 텍스트에서 유용한 정보를 추출하거나 숨겨진 의미 있는 정보를 발견하는 것
| 문서분류 | - 문서의 내용에 따라 분류 - 사전에 분류 정보를 알고있는 상태에서 주제에 따라 분류하는 지도 학습 방식 |
| 문서군집 | - 성격이 비슷한 문서끼리 같은 군집으로 묶어주는 방법 - 분류 정보를 모르는 상태에서 수행하는 비지도 학습 방식 |
| 정보추출 | - 문서에서 중요한 의미를 지닌 정보를 자동으로 추출하는 방법 |
● 오피니언 마이닝
- 어떤 사안/인물/이슈/이벤트에 대한 사람들의 의견/평가/태도/감정 등을 분석하는 것
- 사실과 의견을 구분해 의견을 뽑아내어 긍정과 부정으로 나누고 그 강도를 측정
2. 분석 모형 선정
1) 분석모형의 선정 기준
a. 분석하고자 하는 목적을 명확히 규명해야 함
b. 종속 변수의 존재를 파악해야함
c. 종속 변수의 종류를 파악해야함 (연속/이산)
2) 종속변수에 따른 데이터 분석 모형
- 종속변수가 있는 경우에만 정형 데이터를 지도학습 방식으로학습시키는 것이 가능하므로 종속 변수가 이산형인지 아니면 연속형인지에 따라 분류 모형이나 추정 모형을 적용함
- 만약 종속변수가 없는 데이터라면 비지도 학습 방식을 사용 (상관분석/군집분석/연관분석/요인분석/시계열)
3) 변수 유형에 따른 데이터 분석 모형
- 범주형 (명목/순서)
- 연속형 (구간/비율)
| 연속형 변수 | 회귀분석, 인공신경망, K-means, K-NN, 구조방정식 |
| 범주형 변수 | 로지스틱, 나이브 베이즈, SVM, K-NN |
3. 분석 모형 정의
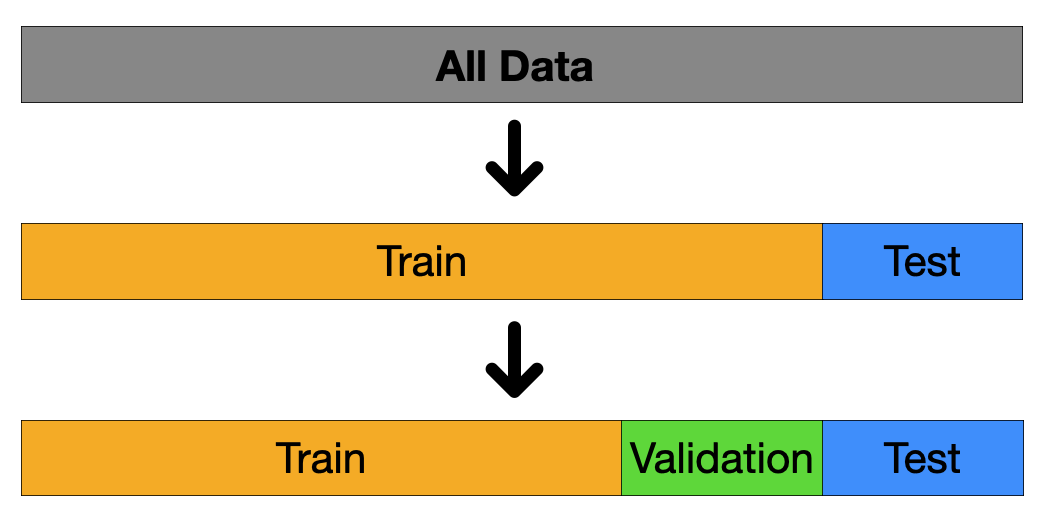
- 훈련(Training), 검증(Validation), 평가(Test) 세 개의 데이터셋을 나누어 모형을 정의함
4. 분석 모형 구축 절차
- 분석 데이터 수집/처리 -> 분석 알고리즘 수행 -> 분석결과 평가 및 모형 선정
1) 분석 데이터 수집/처리
a. 분석 데이터 마트 구성
| 분석 목적 이해 -> 필요 데이터 사전 조사 -> 분석 데이터 선정 |
- 분석 목적에 대한 이해와 어떤 데이터가 적합한 결과를 도출할 수 있을지 사전에 검토한 후 데이터 항목 정의
b. 분석 데이터 현황 분석
| 데이터 항목별 현황 분석 -> 데이터 항목 간 연계 분석 -> 분석 데이터 리스트 작성 |
- 빅데이터 모형 구축에 사용될 데이터가 선정되었으면 해당 데이터에 어떤 변수들이 들어있는지, 형태는 어떠한지 데이터 탐색을 실시
- 기초 통계량 분석, 히스토그램으로 데이터 분포 파악
- 연속형 변수의 경우 평균/분산 등 통계량으로 데이터를 파악
- 범주형 변수의 경우 빈도 분석을 실시하여 범주형 데이터의 분포 파악
2) 분석 알고리즘 수행
a. 분석 알고리즘 선정
● 분석 목적
- 지도/비지도
● 데이터 유형
- 텍스트/소셜
| 정형화된 컬럼 데이터 | 데이터 마이닝 |
| 텍스트 데이터 | 텍스트 마이닝 |
| 링크드 데이터 | 그래프 기반 분석 알고리즘 |
| 이미지 데이터 | 딥러닝 알고리즘 |
● 분석 데이터 볼륨
● 분석 인프라
- 하둡 인프라를 활용할 때에는 하둡 내부 소프트웨어를 이용해 알고리즘 활용 가능
b. 분석 알고리즘 수행
● 데이터셋 준비
- Train / Test / Valid로 구분 (크기는 훈련 > 평가 > 검증 순)
● 파라미터 설정 및 조정
● 분석 결과 기록
- 분석 알고리즘별로 파라미터를 변경하면서 알고리즘을 수행
3) 분석 결과 평가 및 모델 선정
a. 평가 기준
- 지도학습: 분류 정확도 / 평균 오차율 / 오류 재현율
- 비지도 학습: 집도 소속률 / 데이터 밀도 및 군집도
- 기타: 텍스트 매칭률 / 문서 분류율
- 최종 검토한 후 최종 모델을 선정하고 이를 챔피언 모델로 등록
'빅데이터분석기사' 카테고리의 다른 글
| [빅분기] 9.1. 회귀분석 (7) | 2025.08.25 |
|---|---|
| [빅분기] 8.2. 분석 환경 구축 (2) | 2025.08.25 |
| [빅분기] 7.1. 분산분석 (0) | 2025.08.23 |
| [빅분기] 6.2. 추론통계 (2) (7) | 2025.08.23 |