1. 회귀분석의 개념
- 하나 혹은 그 이상의 원인(독립변수)이 결과(종속변수)에 미치는 영향을 추정하는 통계기법
1) 회귀분석에 적합한 데이터 형태
- 종속변수는 계량형 자료여야하지만, 독립변수는 명목척도로 측정된 범주형 자료가 사용될 수 있음 (더미변수)
2) 회귀분석의 변수
- 독립변수, 종속변수
3) 선형회귀분석의 가정
- 독립변수와 종속변수 간의 선형성
- 오차의 등분산성: 오차의 분산은 독립변수 값과 무관하게 일정
- 오차의 정규성
- 오차의 독립성
4) 그래프와 통계량을 활용한 선형회귀분석의 가정 검토
- 정규성: qq-plot이 y=x 그래프와 가까울수록 정규분포를 따름
- 독립성: 더비 왓슨 검정을 수행 (0 ~ 4 범위로, 양 끝에 가까울수록 잔차들간의 상관관계가 존재)
5) 회귀분석의 종류에 따른 가정에 대한 검증
- 단순: 선형성을 검정하기 위해 산점도 확인
- 다중: 선형성, 등분산성, 정규성, 독립성을 모두 만족하는지 확인
2. 단순선형회귀
| Y = B0 + B1x1 + ε |
1) 회귀계수의 추정방법 (최소제곱법, 최소자승법)
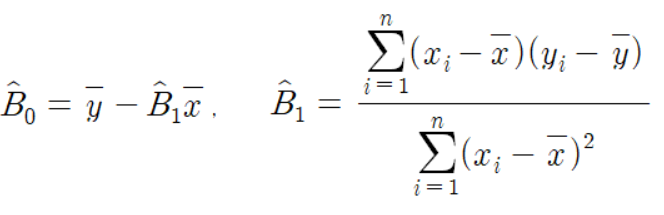
- 회귀분석 시에는 최소제곱법을 이용해 회귀계수를 추정
- 잔차 제곱합을 최소로 만드는 직선을 찾는 것
2) 단순선형회귀분석의 결과 해석
a. 회귀모형은 통계적으로 유의한가? (F-검정)
| 귀무가설: 회귀계수가 0이다 (B1 = 0) 대립가설: 회귀계수가 0이 아니다 (B1 != 0) |
- F-통계량의 p-value가 유의수준 0.05보다 작으면 귀무가설이 기각되어 회귀모형이 유의하다고 판단할 수 있음
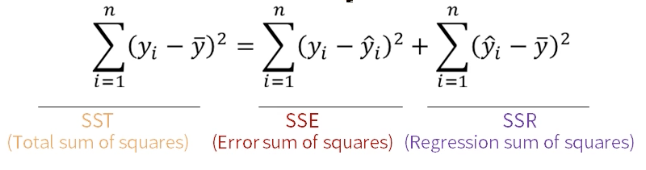
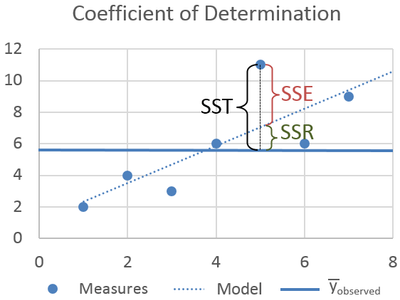
- SST: 총변동
- SSE: 회귀선에 의해 설명되지 않는 변동 (잔차제곱합)
- SSR: 회귀선에 의해 설명되는 변동 (회귀제곱합)
| 요인 | 제곱합(SS) | 자유도 | 평균제곱합(MS) | 분산비 |
| 회귀식 | SSR | 1 | MSR = SSR | MSR/MSE |
| 오차 | SSE | n-2 | MSE = SSE/(n-2) | |
| 계 | SST | n-1 |
- F-통계량은 MSR (평균회귀제곱합) / MSE (평균잔차제곱합) 즉, 해당 값이 클수록 잔차들에 의해 설명되는 변동보다 회귀선에 의해 설명되는 변동이 크기 때문에 회귀선이 독립변수와 종속변수의 관계를 잘 설명하게 되는 것이다
b. 회귀계수는 통계적으로 유의한가? (t-검정)
| 귀무가설: i번째 회귀계수가 0이다(Bi = 0) 대립가설: i번쨰 회귀계수가 0이 아니다(Bi !=0) |
- 회귀계수에 대한 p-value가 0.05보다 작거나 t-통계량의 절대값이 2보다 크면 회귀계수가 유의하다고 판단
c. 모형은 데이터를 얼마나 설명할 수 있는가? (결정계수 확인)
| R^2 = 회귀제곱합/총제곱합 = SSR / SST |
d. 모형이 데이터를 잘 적합하고 있는가?
3. 다중선형회귀
| Y = B0 + B1X1 + B2X2 + ... + BkXk + ε |
1) 다중선형회귀분석 시 검토사항
a. 데이터가 전제하는 가정을 만족시키는가?
- 선형성 / 독립성 / 등분산성 / 정규성
b. 다중공선성
- 독립변수들 간에 강한 상관관계가 나타나는 문제
- 다중공선성 검사 방법은 아래와 같음
- 독립변수들 간의상관계수를 구하여 직접 파악
- 허용오차(한 독립변수의 분산이 다른 독립변수들에 의해 설명되지 않는 부분)를 구했을 때 0.1이하이면 다중공선성 문제가 심각
- 분산팽창요인(VIF) 값이 10 이상이면 공선성이 심각
2) 다중선형회귀분석의 결과 해석
a. 회귀모형은 통계적으로 유의한가? (F-검정)
b. 회귀계수는 통계적으로 유의한가? (t-검정)
c. 모형은 데이터를 얼마나 설명할 수 있는가? (결정계수 확인)
d. 모형이 데이터를 잘 적합하고 있는가? (잔차를 그래프로 그리고 회귀진단 수행)
3) 최적 회귀방정식 선택
a. 단계적 변수선택
| 종류 | 개념 | 장/단점 |
| 전진 선택법 | - 절편만 있는 상수모형에서 시작해 중요하다고 생각하는 변수부터 차례로 모형에 추가 | - 장점: 이해하기 쉽고, 변수 많아도 사용 가능 - 단점: 변수값의 작은 변동에도 결과가 크게 달라져 안정성 부족, 선택되면 제거 불가 |
| 후진 제거법 | - 모든 독립변수를 포함한 상태에서 출발해 하나씩 제거 | - 장점: 전체 변수 정보 이용 - 단점: 변수의 개수가 많으면 사용 어려움 |
| 단계적 방법 | - 전진선택법에 의해 변수를 추가하면서, 새롭게 추가된 변수에 의해 기존 변수의 중요도가 떨어지면 해당 변수를 제거 (반대도 허용) | - 장점: 모든 변수를 고려해 가장 좋은 변수 조합 선택 가능 - 단점: 변수 개수가 많을수록 계산량이 늘어남 |
b. 벌점화된 선택기준
- 모형의 복잡도에 따라 벌점을 주는 방식
- AIC / BIC 값이 최소가 되는 모형을 선택, 일반적으론 AIC 사용
- AIC: 주어진 데이터셋에 대한 통계 모델의 품질을 평가, 최소의 정보 손실을 갖는 모형을 가장 적합한 것으로 취급
- BIC: AIC와 유사하지만, 변수가 많을수록 AIC보다 더 많은 패널티를 가함, 변수 증가에 민감
c. 수정된 결정계수
- 수정된 결정계수는 처음에는 감소하다가 안정화되고, 나중에는 약간 증가
- MSE 값이 최소인 시점의 모형을 선택
d. Mallows's Cp
- 일반적으론 모델에 변수가 추가될수록 잔차 제곱합은 작아짐 그렇기에 잔차 제곱합이 가장 작은 모델을 선택하면 과적합 문제로 이어질 수 있음
- Mallows's Cp는 모든 변수를 사용한 모형과 p개의 독립변수를 사용한 모형이 얼마나 가까운지를 나타내는 통계량
- 즉, 비슷한 성능을 가진다면 변수의 개수가 적은 더 간단한 모형이 좋기 때문에 해당 통계량으로 모형을 선택
- 해당 통계량 값이 작을수록 좋은 값이라 판단
- Cp 값이 작고, p+상수에 가까운 모형을 선택
Cp = p (편향이 작고 우수)
Cp > p (편향이 크고 추가적인 변수가 필요)
Cp < p (분산의 증가폭보다 편향의 감소폭이 더 큼, 필요 없는 변수가 모델에 존재)
4. 정규화 선형회귀
1) 릿지 회귀
- 가중치들의 제곱합을 최소화하는 것을 제약조건으로 추가하는 기법
- 가중치는 0에 가까워질뿐, 0이 될 수 없음
- 가중치의 모든 원소가 0에 가까워지는 것을 원하며, 이런 규제 방식을 L2 규제라고 함
- 하이퍼 파라미터인 람다가 커지면 가중치들의 값이 작아지며, 람다가 0이면 일반적인 선형 회귀모형
2) 라쏘 회귀
- 가중치 절대값의 합을 최소화하는 것을 제약조건으로 추가하는 기법
- 가중치가 0이 될 수 있음
- L1 규제
3) 엘라스틱넷
- 라쏘와 릿지를 결합한 모델
- 가중치 절대값의 합과 제곱합을 동시에 제약조건으로 가지는 모형이므로 하이퍼 파라미터가 2개
5. 회귀분석의 영향력 진단
- 영향력 진단이란 적합도니 회귀모형의 안전성을 평가하는 방법
- 특정 관측치가 제외됨에 따라 분석 결과의 주요 부분에 많은 변동이 있다면 안전성이 약하다고 판단
- 선형회귀분석에서 회귀직선의 기울기에 영향을 크게 주는 것을 영향점이라고 함
| 영향력 진단 방법 |
| Leverage H (지레점, 레버리지) |
| Cook's Distance (쿡의 거리) |
| DFBETAS (Difference in Betas) |
| DFFITS (Difference in Fits) |
'빅데이터분석기사' 카테고리의 다른 글
| [빅분기] 9.3. 범주형 자료 분석 (1) | 2025.08.26 |
|---|---|
| [빅분기] 9.2. 범주형 자료 분석 (5) | 2025.08.26 |
| [빅분기] 8.2. 분석 환경 구축 (2) | 2025.08.25 |
| [빅분기] 8.1. 분석 모형 구축 (5) | 2025.08.25 |