1. 주성분분석
1) 주성분분석의 개념
- 주성분분석이란 데이터에 여러 변수들이 있을 때 서로 상관성이 높은 변수들의 선형결합으로 이루어진 '주성분'이라는 새로운 변수를 만들어 변수들을 요약하고 축소하는 기법
- 첫 번째 주성분으로 전체 변동을 가장 많이 설명할 수 있도록 하고, 각 주성분은 서로 독립이어야함
2) 주성분분석의 목적
- 여러 변수들 간에 내재하는 상관관계, 연관성을 이용해 소수의 주성분으로 차원을 축소함으로써 데이터를 이해하고 관리하기 쉽게 해줌
- 다중공선성이 존재하는 경우, 상관성이 없는(적은) 주성분으로 변수들을 축소하여 모형 개발에 활용
- 주성분분석 이후 군집분석을 수행하면 군집화 결과와 연산 속도를 개선할 수 있음
3) 주성분의 선택
a. 기여율
- 주성분은 여러 변수들의 선형결합이므로, 각 변수에 내재되어 있는 중요한 정보의 손실이 있을 수도 있음 따라서 '주성분 기여율'을 사용해 주성분이 데이터를 얼마나 잘 설명할 수 있는지를 평가함
- 주성분 기여율은 원 변수의 총 변동 분의 주성분 변수의 분산으로, 총 변동에 대한 주성분의 설명력을 의미함
- 주성분의 분산이 전체 데이터의 흩어진 정도와 비슷하다면 해당 주성분은 적절하다고 판단 (기여율은 1에 가까울수록 적절)
- 첫 번째 주성분부터 차례대로 기여율을 합한 누적 기여율이 85%이상이 되면 해당 지점까지를 주성분의 수로 결정
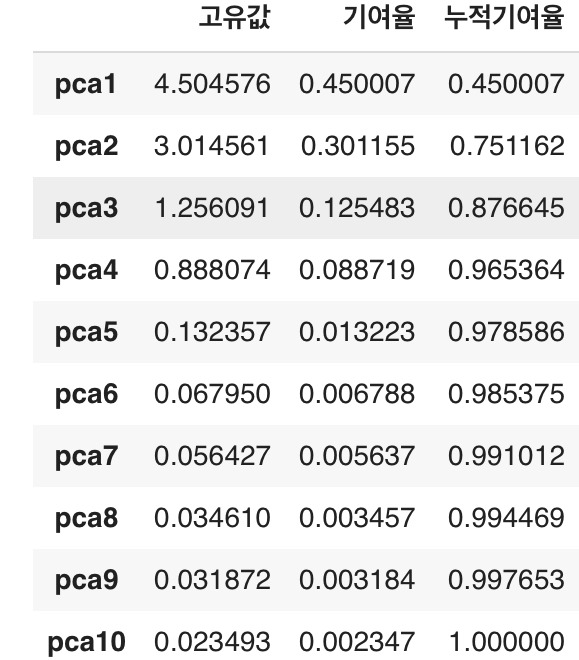
- 위의 경우, 주성분의 수를 세 개로 결정
b. 스크리 산점도
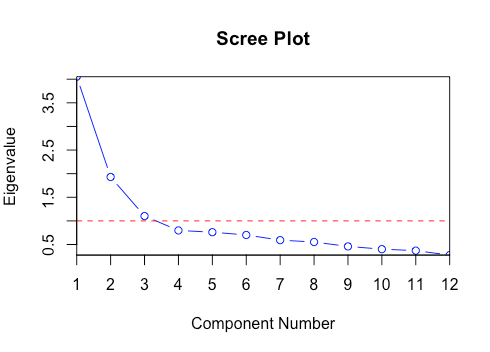
- 주성분을 x축, 각 주성분의 고유값(주성분의 분산)을 y축에 둔 그래프
- 고유치가 급격히 완만해지는 지점의 바로 전 단계로 주성분의 수를 선택
2. 요인분석
1) 요인분석의 개념
- 여러 개의 변수들로 이루어진 데이터에서 변수들 간의 상관관계를 고려하여 서로 유사한 변수들을 묶어 새로운 잠재요인을 추출해내는 분석방법, 변수를 축소하고 데이터를 요약하는 데 사용
- ex) 국어, 영어, 중국어를 [언어능력]으로 새롭게 구성
- 변수가 간격척도 혹은 비율척도로 측정되어야 하며, 표본의 크기는 최소 50개 이상이어야함
2) 주성분분석 vs 요인분석
| 주성분분석 | 요인분석 | |
| 공통점 | - 원 데이터를 활용하여 몇 개의 새로운 변수를 생성 - 변수 축소 및 데이터 요약에 사용 |
|
| 생성되는 변수의 수 | - 통상적으로 2개 (제1, 제2 주성분) | - 지정된 개수 없음 |
| 생성되는 변수의 이름 | - 제1주성분, 제2주성분 등 | - 임의로 지정 |
| 생성되는 변수들의 관계 | - 제1주성분이 가장 중요, 그 다음으로 제2 | - 대등한 관계 |
| 분석방법의 의미 | - 목표변수를 잘 예측/분류하기 위해 기존 변수들의 선형 결합으로 이루어진 주성분을 찾아냄 | - 목표변수를 고려하지 않고 주어진 변수들을 비슷한 성격으로 묶어서 새로운 변수를 생성 |
3) 요인분석의 용어
| 용어 | 설명 |
| 요인 | - 상관계수가 높은 변수들을 묶어 새롭게 생성한 변수 집단 |
| 요인 적재값 | - 변수와 해당 요인간의 상관계수 - 요인 적재값의 제곱은 해당 변수가 요인에 의해 설명되는 분산의 비율 |
| 요인행렬 | - 요인들에 대한 모든 변수의 요인 적재값을 모은 행렬 |
| 고유값 | - 각 요인에 대한 모든 변수들의 요인 적재값 제곱의 합 - 변수 속 정보(분산)가 어떤 요인에 의해 어느 정도 설명될 수 있는지를 나타내는 비율 |
| 공통성 | - 여러 요인이 설명할 수 있는 한 변수의 분산의 양을 백분율로 나타낸 것 - 한 변수의 공통성은 추출된 요인들이 그 변수의 정보를 얼마만큼 설명할 수 있는지를 의미 - 0과 1사이의 값을 가짐 |
4) 요인추출 방법
- 요인을 추출하는 방법에는 주성분 분석과 공통요인 분석이 있으며, 주성분분석이 널리 이용됨
- 주성분분석: 변수들로부터 요인을 추출하는 방식, 전체 분산을 토대로 요인을 추출
- 공통요인분석: 잠재요인으로부터 변수들이 산출된 것으로 보는 방식으로, 공통분산만을 토대로 요인을 추출
5) 요인의 수 결정
- 고유값을 기준으로 할 때는, 고유값이 1이상에 해당하는 요인들을 추출
- 스크리 도표에서 요인의 설명력이 완만한 하락으로 추세가 바뀌기의 직전 요인의 수
6) 요인 분석의 절차
a. 데이터 입력
b. 상관계수 산출
c. 요인추출
d. 요인 적재량 산출
e. 요인회전 (분산을 재분배)
f. 생성된 요인 해석
g. 요인점수 산출
3. 판별분석
1) 판별분석의 개념
- 분류 기법 중 하나로, 집단에 대한 정보로부터 집단을 구별할 수 있는 판별함수 혹은 판별규칙을 만들고, 새로운 개체가 어느 집단에 속하는지를 판별하여 분류하는 다변량 기법
- 독립변수: 간격/비율 (숫자)
- 종속변수: 명목/서열 (범주)
2) 판별식의 도출
- 판별분석에서는 그룹 내 분산에 비하여 그룹 간 분산의 차이를 최대화하는 독립변수들의 계수를 찾아냄
- 독립변수들의 선형결합을 판별함수 혹은 판별싱기알고 함
| Z= W1X1 + W2X2 + ...+ WnXn Z = 판별점수 Wi = 변수 i에 대한 판별 계수 Xi = 독립변수 i |
- 판별함수는 '집단의 수 -1'과 '독립변수의 수' 중 더 작은 값만큼 만들어지며, 첫 번째로 계산된 판별식이 집단을 잘 구분해줌
3) 판별분석의 가정
- 독립변수는 다변량 정규분포를 이룸 (정규성 위반시 추정에 문제, -> 이땐 로지스틱 분석 사용)
- 종속 변수에 의해 범주화되는 그룹들의 분산-공분산행렬이 동일해야함
4) 판별함수에 포함될 독립변수의 선택방법
- 판별함수를 발견하는 과정에는 동시입력방식과 단계입력방식이 있음
- 동시입력방식: 모든 독립변수들에 대한 계수를 동시에 계산
- 단계입력방식: 판별력이 높은 순서로 변수가 입력
5) 적합도 평가
- 판별함수의 판별력에 대한 통계적 유의성 검정을 위해가장 흔히 사용되는 값은 Wilk's lamda이며, 카이제곱 검증을 실시
- 판별함수의 전반적인 적합도 점검을 위해서는 hit ratio를 확인
- hit ratio는 정확히 분류된 대상의 수를 전체 대상의 수로 나눈 값
- 판별함수의 판별력이 통계적으로 유의하더라도 hit ratio가 낮으면 판별력이 낮다고 판단
4. 정준상관분석
1) 정준상관분석의 개념
- 두 개의 변수 집단 간의 선형 관계를 파악하고 양으로 표현하고자 할 때 사용되는 기법
- 두 변수 집단의 의존관계를 파악하는 것이므로 독립변수와 종속변수의 구분이 없음
- 다차원에 놓인 두 변수 집단 간의 관계를 저차원의 정준변수 쌍으로 전환하여 관계를 설명할 수 있으며 정준상관계수가 정준변수 간의 상관성을 나타냄
- 복잡한 변수들 간의 관계와 패턴을 찾아내 의사 결정에 도움을 줌
2) 정준상관분석의 용어
| 용어 | 설명 |
| 정준변수 | 변수그룹의 선형결합으로, 변수그룹과의 선형결합의 상관계수를 최대로 하는 변수 |
| 정준계수 | 정준변수를 구성하는 계수 |
| 정준상관계수 | 두 변수 그룹의 연관성 정도 |
| 정준적재값 | 측정변수와 정준변수 사이의 상관계수 |
3) 정준변수의 특징
- 인공적으로 만들어낸 변수이므로 인자나 주성분과 같은 절대적 의미를 부여하기는 어려움 (단순히 연관성)
- 변수를 표준화하더라도 정준상관계수는 변하지 않으므로, 단위의 표준화와 해석을 위해서는 표준화 변수들에 대한 정준상관분석을 권장)
'빅데이터분석기사' 카테고리의 다른 글
| [빅분기] 9.6. 비모수 통계 (8) | 2025.08.27 |
|---|---|
| [빅분기] 9.5. 시계열 분석 (3) | 2025.08.26 |
| [빅분기] 9.3. 범주형 자료 분석 (1) | 2025.08.26 |
| [빅분기] 9.2. 범주형 자료 분석 (5) | 2025.08.26 |