1. 범주형 자료 분석
a. 범주 -> 범주 : 카이제곱 검정, 분할표 분석
b. 범주 -> 연속 : T-검정, 분산분석
c. 연속 -> 범주 : 로지스틱 회귀분석
2. 분할표 분석
1) 개요
- 여러 개의 범주형 변수를 기준으로 빈도를 표 형태로 나타낸 것
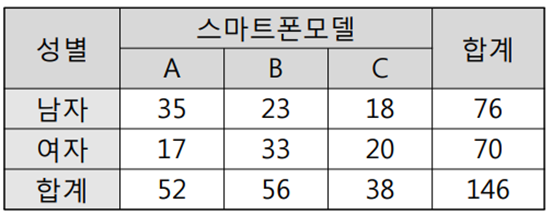
- 행은 설명변수, 열은 반응변수를 의미
2) 상대위험도
- 상대위험도란 관심 집단의 위험률/비교 집단의 위험률을 의미하며 위험률이란 특정 사건이 발생할 비율을 의미함
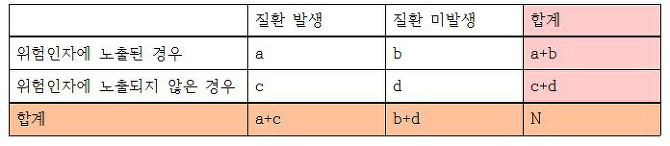
- 상대위험도(RR) : 위험인자에 노출된 환자의 비율 / 위험인자에 노출되지 않은 환자의 비율 = (a/a+b) / (c/c+d)
3) 오즈비
- 오즈란 성공확률/실패확률로, 성공할 확률이 실패할 확률의 몇 배인지를 나타냄
- 오즈비란 오즈의 각 범주별 비율
| 구분 | 16강 성공 확률 | 16강 실패 확률 |
| 브라질 | 0.8 | 0.2 |
| 한국 | 0.1 | 0.9 |
- Odds(브라질) = 0.8/(1-0.8) = 4
- Odds(한국) = 0.1/(1-0.1) = 1/9
- Odds ratio = Odds(브라질) / Odds(한국) = 36
- 즉, 브라질의 16강 진출 확률이 한국의 16강 진출 확률보다 36배 높다고 해석가능
3. 교차분석
1) 카이제곱 검정
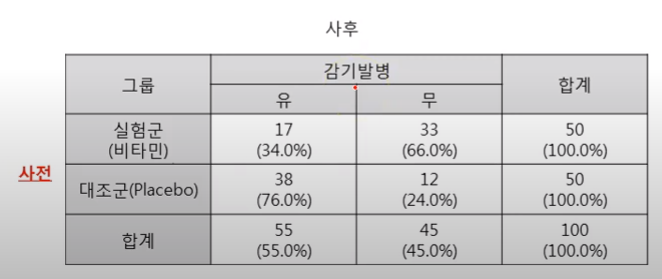
- 범주형 자료인 두 변수 간의 관계를 알아보기 위해 실시하는 분석
2) 교차표
4. 적합성 검정
1) 적합성 검정
- 실험에서 얻어진 관측값들이 예상한 이론과 일치하는지 아닌지를 검정하는 방법
- 관측값들이 어떠한 이론적 분포를 따르고 있는지를 알아봄
2) 가설 설정
- n개의 표본 자료를 k개의 범주로 분류한 뒤, 각 범주의 관측도수(O)와 주어진 확률 분포에 대해 각 범주에 속하는 기대도수(E)들이 적합하는지의 여부를 검정
- 귀무가설: 실제 분포와 이론적 분포 간에는 차이가 없다 (두 분포가 일치한다)
- 대립가설: 실제 분포와 이론적 분포 간에는 차이가 있다
3) 검정통계량
- 카이제곱 값은 sigma (O-E)^2 / E로 나타남
| 요일 | 월 | 화 | 수 | 목 | 금 | 토 | 일 |
| 관측도수 O | 50 | 65 | 80 | 74 | 85 | 90 | 56 |
| 기대도수 E | 70 | 70 | 70 | 70 | 70 | 70 | 70 |
| (O-E)^2 / E | 5.71 | 0.36 | 1.43 | 0.23 | 3.21 | 5.71 | 2.80 |
- 카이제곱 통계량이 큰 경우, 관찰도수와 기대도수의 차이가 크며, 적합도가 낮다 즉, 예상 이론과 일치한다고 볼 수 없다
4) 자유도
- df = k-1
5. 독립성 검정
1) 독립성 검정
- 모집단이 두 개의 변수 A,B에 의해 범주화되었을 때, 이 두 변수들 사이의 관계가 독립인지 아닌지를 검정하는 것
| 가 (변수A) | 나 (변수A) | 다 (변수A) | 합 | |
| TRUE (변수B) | 30 | 20 | 50 | 100 |
| FALSE (변수B) | 50 | 70 | 60 | 180 |
| 합 | 80 | 90 | 110 | 280 |
- A는 가,나,다 B는 T/F를 가질 수 있다고 가정
- 변수 A가 '가'일 확률은 80/280, 변수 B가 'TRUE'일 확률은 100/280
- 만약 A와 B가 독립이라면 변수A가 '가'이면서 변수 B가 'TRUE'일 확률은 80/280 * 100/280
2) 가설 설정
- A,B가 서로 독립적으로 관측값에 영향을 미치는지 검정
- 귀무가설: 두 변수 사이에는 연관이 없다 (독립이다)
- 대립가설: 두 변수 사이에는 연관이 있다 (종속이다)
3) 검정통계량
4) 자유도
- df = (R-1) * (C-1)
- R= 행의 수, C = 열의 수
6. 동질성 검정
1) 동질성 검정
- 모집단이 임의의 변수에 따라 R개의 속성으로 범주화되었을 때, R개의 부분 모집단에서 추출한 각 표본인 C개의 범주화된 집단의 분포가 서로 동일한지를 검정하는 것
- 독립성 검정 방법과 똑같이 진행
2) 가설 설정
- j = 1, 2 , ..., c이다
- 귀무가설: P_1j = P_2j = ... = Prj (모든 P_nj는 동일하다)
- 대립가설: Not H0 (P_nj 중 다른 값이 하나 이상 존재한다)
3) 검정통계량
4) 자유도
- df = (R-1) * (C-1)
- R= 행의 수, C = 열의 수
'빅데이터분석기사' 카테고리의 다른 글
| [빅분기] 9.4. 다변량 분석 (3) | 2025.08.26 |
|---|---|
| [빅분기] 9.3. 범주형 자료 분석 (1) | 2025.08.26 |
| [빅분기] 9.1. 회귀분석 (7) | 2025.08.25 |
| [빅분기] 8.2. 분석 환경 구축 (2) | 2025.08.25 |